RESEARCH MAP · SNAPSHOT 2026-10-14

Video Gen 与推理,
在各个 venue 中处于什么位置?

2024–2026 · 12 个 venue · 两种分母 · 严格主统计 + 宽口径候选

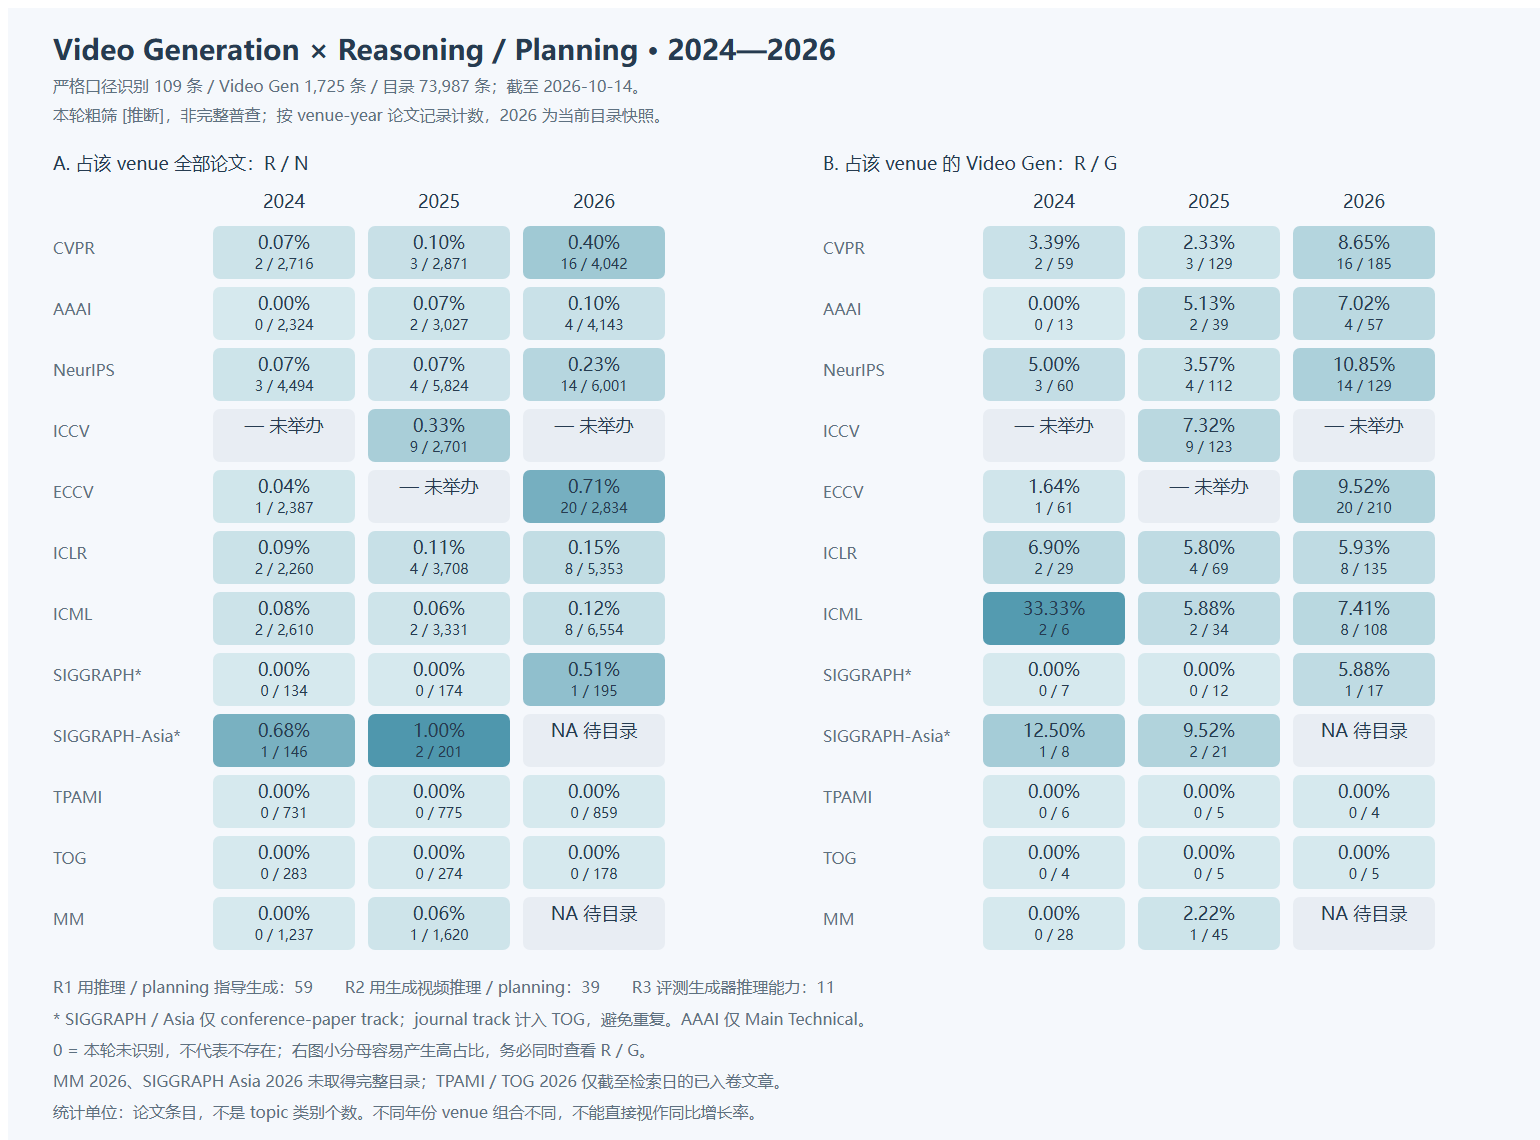
这是目录快照上的粗筛结果 [推断],不是全领域精确普查。N = 当前口径下的全部论文记录;G = Video Gen 粗筛记录;R = 有摘要证据支持的严格推理 / planning 记录。所有比例均按论文数计算,不是 topic 类别数。

Editing、Control 和几何一致,属于不同分类轴

Video editing 不等同于 video control。生成式 editing 通常是 controllable video synthesis 的一种应用。Control 描述用什么条件约束输出;editing 描述是否修改一个已有视频实例;几何一致描述输出必须满足什么性质。

任务轴:是否修改已有实例?

源视频 + 修改指令 + 保持约束
↓
编辑后视频 · Editing

例如:删除碰撞物体,同时修正碰撞后果,保留无关人物和背景。

控制轴:如何约束生成?

相机 / 轨迹 / 姿态 / 身份参考 / 文本
↓
从头生成新视频
修改已有视频

两边都可以使用条件控制,也都可以要求几何一致。

例子Editing?Control?解释
输入相机轨迹,从一张图生成新视频通常否是没有要求保留某个源视频的既有过程。
重拍原视频,只改变相机路径是是源视频编辑 + 相机控制 + 几何保持。
输入某人的参考照,生成新剧情通常否是身份定制;使用参考不等于编辑参考实例。
让多视角生成符合相同 3D 场景取决于任务取决于输入几何一致本身是目标性质。

你的研究最适合写成:事件 / 状态层面的选择性编辑 + 干预后果推理 + 无关内容保持。它与 Control 相交,但比“让物体沿轨迹运动”多了决定什么必须改变、什么必须保持的推断问题。

先看已有五会的 topic 构成

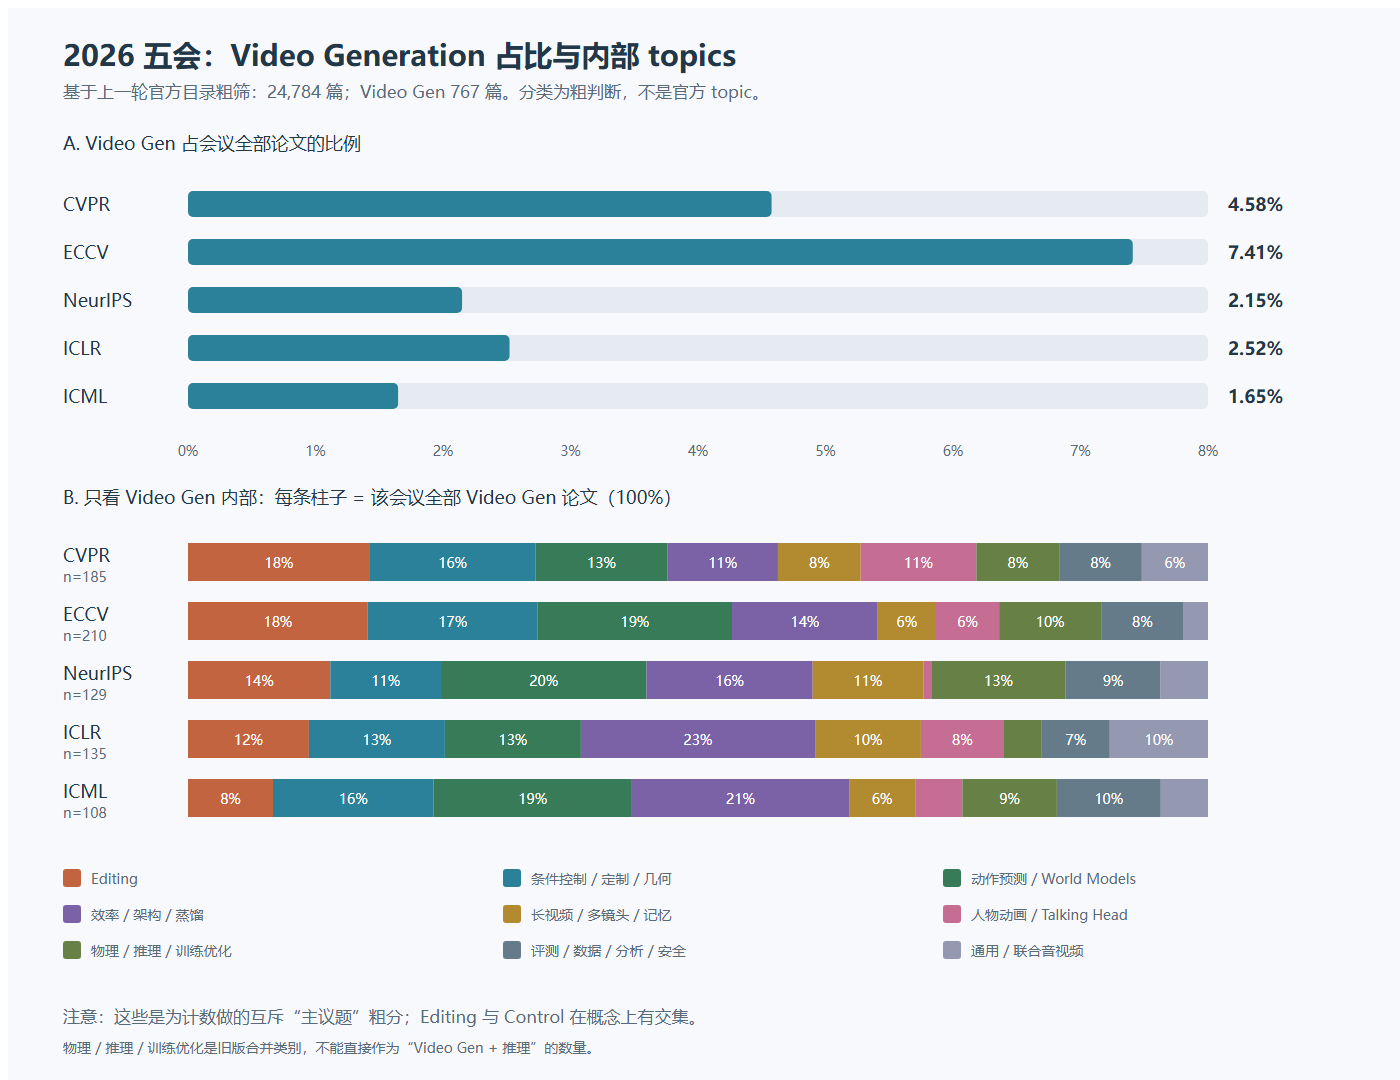
保留上一轮 767 篇 Video Gen 的基线。上图分母是会议全部论文,下图分母是该会议的 Video Gen。旧主标签混合了任务、方法和目标,仅作为描述性分组。

2026 五会:Video Generation 占比与内部 topics基于上一轮官方目录粗筛:24,784 篇;Video Gen 767 篇。分类为粗判断,不是官方 topic。A. Video Gen 占会议全部论文的比例CVPR4.58%ECCV7.41%NeurIPS2.15%ICLR2.52%ICML1.65%0%1%2%3%4%5%6%7%8%B. 只看 Video Gen 内部:每条柱子 = 该会议全部 Video Gen 论文(100%)CVPRn=185Editing / 修改已有视频:33 篇,17.8%18%条件控制 / 定制 / 几何一致:30 篇,16.2%16%动作预测 / 交互 World Models:24 篇,13.0%13%效率 / 架构 / 蒸馏 / 实时:20 篇,10.8%11%长视频 / 多镜头 / 记忆:15 篇,8.1%8%人物动画 / Talking Head / HOI:21 篇,11.4%11%质量 / 物理 / 推理 / 训练优化:15 篇,8.1%8%评测 / 数据 / 分析 / 安全:15 篇,8.1%8%通用生成框架 / 联合音视频:12 篇,6.5%6%ECCVn=210Editing / 修改已有视频:37 篇,17.6%18%条件控制 / 定制 / 几何一致:35 篇,16.7%17%动作预测 / 交互 World Models:40 篇,19.0%19%效率 / 架构 / 蒸馏 / 实时:30 篇,14.3%14%长视频 / 多镜头 / 记忆:12 篇,5.7%6%人物动画 / Talking Head / HOI:13 篇,6.2%6%质量 / 物理 / 推理 / 训练优化:21 篇,10.0%10%评测 / 数据 / 分析 / 安全:17 篇,8.1%8%通用生成框架 / 联合音视频:5 篇,2.4%NeurIPSn=129Editing / 修改已有视频:18 篇,14.0%14%条件控制 / 定制 / 几何一致:14 篇,10.9%11%动作预测 / 交互 World Models:26 篇,20.2%20%效率 / 架构 / 蒸馏 / 实时:21 篇,16.3%16%长视频 / 多镜头 / 记忆:14 篇,10.9%11%人物动画 / Talking Head / HOI:1 篇,0.8%质量 / 物理 / 推理 / 训练优化:17 篇,13.2%13%评测 / 数据 / 分析 / 安全:12 篇,9.3%9%通用生成框架 / 联合音视频:6 篇,4.7%ICLRn=135Editing / 修改已有视频:16 篇,11.9%12%条件控制 / 定制 / 几何一致:18 篇,13.3%13%动作预测 / 交互 World Models:18 篇,13.3%13%效率 / 架构 / 蒸馏 / 实时:31 篇,23.0%23%长视频 / 多镜头 / 记忆:14 篇,10.4%10%人物动画 / Talking Head / HOI:11 篇,8.1%8%质量 / 物理 / 推理 / 训练优化:5 篇,3.7%评测 / 数据 / 分析 / 安全:9 篇,6.7%7%通用生成框架 / 联合音视频:13 篇,9.6%10%ICMLn=108Editing / 修改已有视频:9 篇,8.3%8%条件控制 / 定制 / 几何一致:17 篇,15.7%16%动作预测 / 交互 World Models:21 篇,19.4%19%效率 / 架构 / 蒸馏 / 实时:23 篇,21.3%21%长视频 / 多镜头 / 记忆:7 篇,6.5%6%人物动画 / Talking Head / HOI:5 篇,4.6%质量 / 物理 / 推理 / 训练优化:10 篇,9.3%9%评测 / 数据 / 分析 / 安全:11 篇,10.2%10%通用生成框架 / 联合音视频:5 篇,4.6%Editing条件控制 / 定制 / 几何动作预测 / World Models效率 / 架构 / 蒸馏长视频 / 多镜头 / 记忆人物动画 / Talking Head物理 / 推理 / 训练优化评测 / 数据 / 分析 / 安全通用 / 联合音视频注意:这些是为计数做的互斥“主议题”粗分;Editing 与 Control 在概念上有交集。物理 / 推理 / 训练优化是旧版合并类别,不能直接作为“Video Gen + 推理”的数量。

下载 PNG · 下载 SVG

旧类别“质量 / 物理 / 推理 / 训练优化”不能当作推理论文数。本页的严格 R 是重新核对摘要后的独立标签。

同一批推理论文,换两个分母看

全 venue 占比 = R ÷ N
回答:这个方向在整个会议 / 期刊里有多大?
Video Gen 内占比 = R ÷ G
回答:这个方向在视频生成研究里有多大?
Video Generation × Reasoning / Planning · 2024—2026严格口径识别 109 条 / Video Gen 1,725 条 / 目录 73,987 条;截至 2026-10-14。本轮粗筛 [推断],非完整普查;按 venue-year 论文记录计数,2026 为当前目录快照。A. 占该 venue 全部论文:R / N202420252026CVPR0.07%2 / 2,7160.10%3 / 2,8710.40%16 / 4,042AAAI0.00%0 / 2,3240.07%2 / 3,0270.10%4 / 4,143NeurIPS0.07%3 / 4,4940.07%4 / 5,8240.23%14 / 6,001ICCV— 未举办0.33%9 / 2,701— 未举办ECCV0.04%1 / 2,387— 未举办0.71%20 / 2,834ICLR0.09%2 / 2,2600.11%4 / 3,7080.15%8 / 5,353ICML0.08%2 / 2,6100.06%2 / 3,3310.12%8 / 6,554SIGGRAPH*0.00%0 / 1340.00%0 / 1740.51%1 / 195SIGGRAPH-Asia*0.68%1 / 1461.00%2 / 201NA 待目录TPAMI0.00%0 / 7310.00%0 / 7750.00%0 / 859TOG0.00%0 / 2830.00%0 / 2740.00%0 / 178MM0.00%0 / 1,2370.06%1 / 1,620NA 待目录B. 占该 venue 的 Video Gen:R / G202420252026CVPR3.39%2 / 592.33%3 / 1298.65%16 / 185AAAI0.00%0 / 135.13%2 / 397.02%4 / 57NeurIPS5.00%3 / 603.57%4 / 11210.85%14 / 129ICCV— 未举办7.32%9 / 123— 未举办ECCV1.64%1 / 61— 未举办9.52%20 / 210ICLR6.90%2 / 295.80%4 / 695.93%8 / 135ICML33.33%2 / 65.88%2 / 347.41%8 / 108SIGGRAPH*0.00%0 / 70.00%0 / 125.88%1 / 17SIGGRAPH-Asia*12.50%1 / 89.52%2 / 21NA 待目录TPAMI0.00%0 / 60.00%0 / 50.00%0 / 4TOG0.00%0 / 40.00%0 / 50.00%0 / 5MM0.00%0 / 282.22%1 / 45NA 待目录R1 用推理 / planning 指导生成:59  R2 用生成视频推理 / planning:39  R3 评测生成器推理能力:11* SIGGRAPH / Asia 仅 conference-paper track;journal track 计入 TOG,避免重复。AAAI 仅 Main Technical。0 = 本轮未识别,不代表不存在;右图小分母容易产生高占比,务必同时查看 R / G。MM 2026、SIGGRAPH Asia 2026 未取得完整目录;TPAMI / TOG 2026 仅截至检索日的已入卷文章。统计单位:论文条目,不是 topic 类别个数。不同年份 venue 组合不同,不能直接视作同比增长率。

下载 PNG · 下载 SVG · 下载全部 36 格 CSV

三年的 venue 组合不同,且 2026 尚未结束;以上年度合计是所覆盖目录的描述,不能直接解释为全领域同比增长。右图中如 ICML 2024 的高比例来自小分母,应同时看 R / G。

把推理放回 Video Gen 内部 topics

这里优先把严格论文分入 R1 / R2 / R3,再展示剩余论文的主 topic,因此每条记录只计一次。概念本身仍可交叉,例如 reasoning-guided editing 同时属于 editing。

悬停色块可看数量与占比。全部论文模式中的灰色包含非 Video Gen 及未纳入主范围的边界项;没有继续细分 NLP、理解、检索等非生成 topics。

逐 venue、逐年份的可核对数量

R1:推理 / planning 指导生成;R2:生成视频参与推理 / planning;R3:评测生成器的推理能力。宽口径候选不进入 R。

Venue / 年NGG/NRR/NR/GR1 / R2 / R3宽候选G 摘要覆盖状态 / 来源

点击有数据的行,会跳到该 venue-year 的严格论文清单。0 表示本轮未识别到符合口径的论文;NA 是缺目录,— 是该年未举办。

逐篇检查:为什么算,为什么暂不算

严格清单 CSV · 宽候选 CSV · Video Gen 与边界项 CSV · 全部目录与筛选结果 CSV

统计口径与覆盖限制

严格纳入

R1:论文明确提出推理、规划、任务分解或 plan–generate–verify 过程,并用其指导视频内容、编辑或训练信号。普通 caption 改写、LLM text encoder、causal attention 不自动纳入。

R2:视频生成的状态 / 帧 / rollout 被实际用于推理回答、动作规划或联合视频–轨迹规划。只称“未来可能帮助规划”不纳入;纯 latent RL world model 不属于这里的 Video Gen。

R3:明确评测视频生成器的推理、规则归纳、规划或因果过程能力。用 CoT 评价画质不等于评测生成器的推理能力。

宽口径与不确定项

另列物理一致、干预 / counterfactual、普通 RL / reward / search、推理式质量 evaluator,以及尚不能区分显式推理和一般条件预测的论文。这份候选集用于复核,不应视作“宽口径已确认篇数”。

Video Gen 包括直接生成 / 修改视频、其专用组件、数据、评测,以及确有视频输出的交互世界模型。排除纯理解、检索、普通恢复 / 超分、纯静态 3D 和仅 latent 的规划系统。

所有标签都是本轮判断 [推断];严格 R 已核对摘要,尚未逐篇读全文。G 是标题与可用摘要粗筛;未抽样审计漏检率,不给置信区间。

来源组处理规则
CVPR / ICCVCVF 主会目录;排除 workshops;标题计数与公开摘要。
ICLR / ICML / NeurIPS / ECCV官方 virtual 目录;按规范化标题、相同 OpenReview forum 合并重复展示;排除 journal-to-conference、blog。NeurIPS 包含 Datasets/Evaluations 与 Position,ICML 包含 Position。
AAAI仅 Main Technical:2024 Vol 38 Issues 1–18;2025 Vol 39 Issues 1–25;2026 Vol 40 Issues 1–43。Special tracks、IAAI、EAAI、student abstracts 等不计入此分母。
SIGGRAPH / SIGGRAPH Asia / TOGSIGGRAPH 两行仅 conference-paper track;journal track 在 TOG 行体现。TOG 按卷年,不重复加回 SIGGRAPH。此表不能直接解释为 SIGGRAPH 全部 technical papers 的规模。
TPAMI / TOG使用出版商提交给 Crossref 的记录;按卷年,排除未入卷 early access、勘误、编辑性条目。2026 是截至检索日已入卷数据。
MMACM 主论文集的 proceedings-article,包括论文集内短文及挑战赛等;不是仅 regular papers。2026 官方网站与 Crossref 尚未提供本轮能核对的完整篇目,保留 NA。
缺失摘要CVF 单篇页、会议单篇展示页、arXiv 补查;部分 ACM / TPAMI 采用 OpenAlex 按 DOI 索引的摘要。摘要覆盖见逐年表。摘要不足的论文不进入严格 R。

不同 venue 的收录 track 不完全相同,论文总量是这里明确列出的目录口径,不是统一意义的官方 acceptance count。跨 venue 合计按记录计;同一工作的期刊扩展版不据标题强行合并。

来源入口与每格口径
复核建议

先检查 R1 / R2 的边界,尤其是把视觉规划实验列为 R2 的 world models;再全文复核你最关心的 editing ∩ reasoning 子集。若缩窄为“生成视频本身执行符号 / 因果推理”,应从当前 R2 / R3 中进一步筛选,不能把整个 113 条直接当作该更窄方向。
本页完全离线可用。图表为原生 SVG,统计表与论文清单可导出。CSV 与图表由同一份标注数据生成。